Migration ETL - de l'ETL legacy vers dbt
La migration vers dbt consiste à transformer des traitements ETL propriétaires en modèles SQL exécutés directement dans le moteur de données cible.
Avant toute conversion, {openAudit} analyse les flux, les dépendances et les usages afin d’identifier le périmètre réellement utile.
Point clé : la migration commence par une phase de rationalisation du patrimoine existant.
Analyse des flux
Les traitements ETL sont analysés pour reconstruire les dépendances, les transformations et les usages.
Le data lineage est utilisé pour identifier les flux actifs, les branches mortes et les composants non consommés.
Cette phase permet de réduire le volume de traitements à migrer.
Résultat : un périmètre de migration recentré sur les traitements réellement utilisés.
Conversion vers le SQL
Les jobs ETL sont décomposés en opérations élémentaires : filtres, jointures, agrégations, lookups, calculs métier et transformations.
Ces composants sont convertis en SQL documenté et indépendant de la technologie source.
Le SQL devient la représentation pivot des traitements.
Point clé : la logique métier est reconstruite en SQL avant génération du projet dbt.
Génération des modèles dbt
Les traitements SQL sont organisés sous forme de modèles dbt.
Les dépendances entre modèles sont générées automatiquement à partir des flux identifiés pendant l’analyse.
La structure du projet, les références entre modèles et la documentation peuvent être produites automatiquement.
Validation progressive
La migration est réalisée par lots.
Les modèles générés sont validés puis intégrés progressivement dans l’environnement cible.
Les écarts peuvent être contrôlés traitement par traitement pendant la phase de transition.
Usage typique : migration progressive de plusieurs centaines de jobs ETL vers dbt.
Architecture cible
Les traitements deviennent des modèles SQL versionnables et maintenables.
Les dépendances sont explicites, les transformations sont visibles et les traitements peuvent être exécutés directement par Snowflake, BigQuery, Databricks SQL, Redshift, PostgreSQL ou tout autre moteur compatible.
Point clé : les traitements ne dépendent plus de la plateforme ETL historique mais d’un projet dbt basé sur du SQL ouvert.
{oa-tbx} : la cible recommandée
Réécrire des jobs DataStage, PowerCenter, BODS, Talend, ODI ou SSIS dans un autre ETL propriétaire, c’est reconduire les licences, l’infrastructure dédiée et le lock-in éditeur.
{oa-tbx} est un ETL SQL open source et serverless, avec moteur DuckDB embarqué. Les jobs transcrits automatiquement en SQL par {openAudit} y sont exécutés sous forme de pipelines orchestrés par Airflow, sans infrastructure dédiée.
Le SQL généré pour dbt peut tout aussi bien être exécuté dans {oa-tbx} : le format pivot reste le même, seul l’environnement d’exécution change.
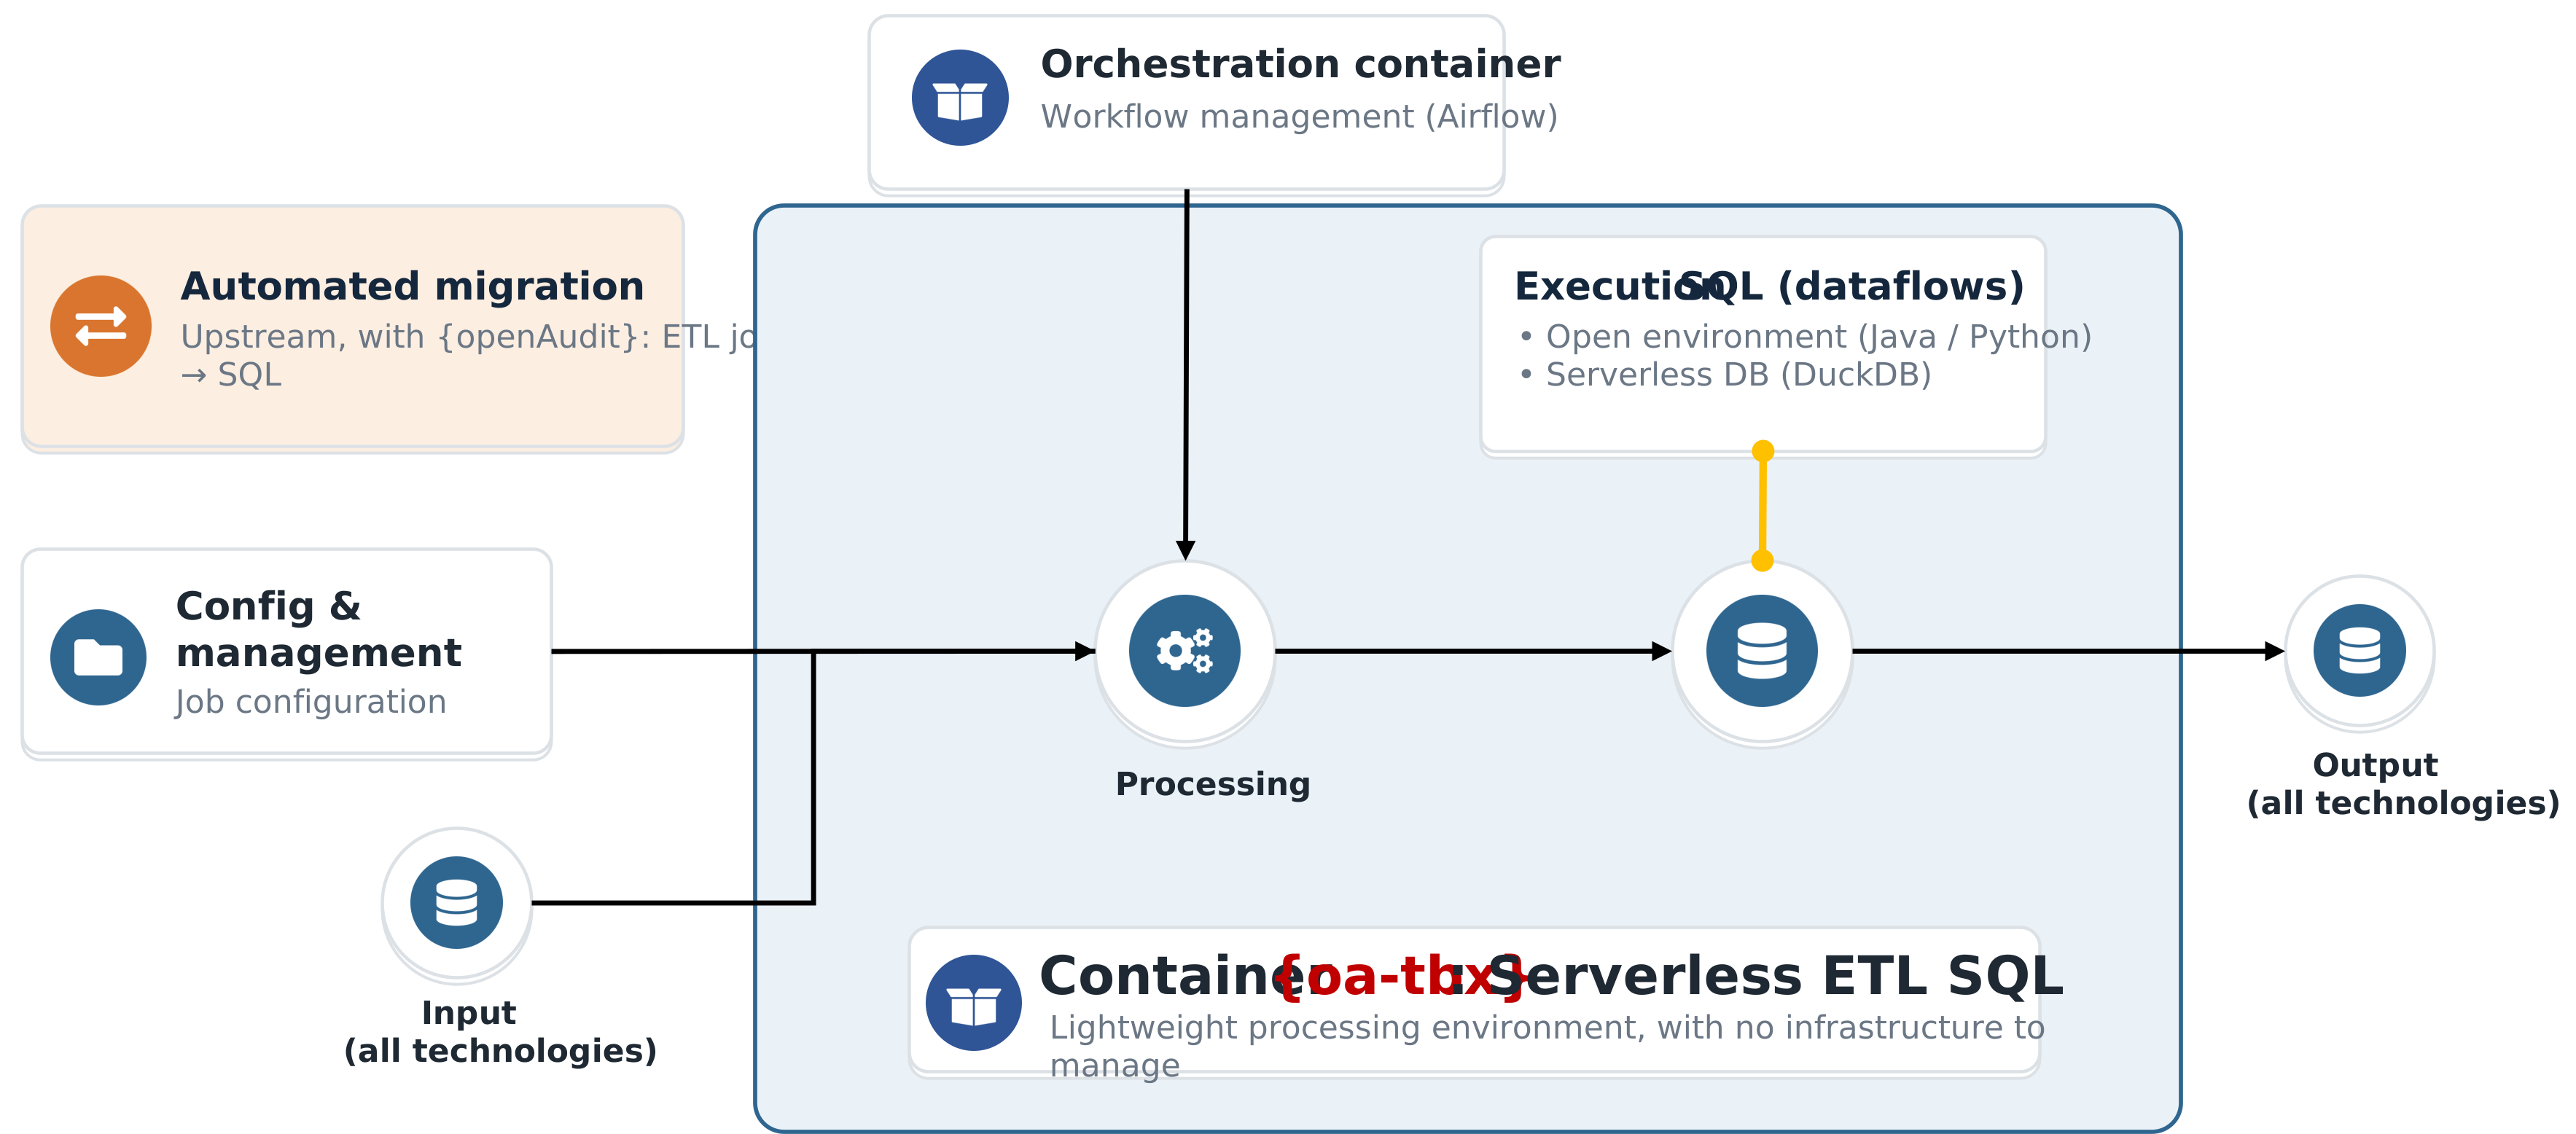
- Transcription automatique : {openAudit} convertit les jobs legacy en SQL à plat, sans des mois de reverse engineering.
- Orchestration ouverte : la séquence de jobs de l’ETL source est reprise à l’identique sous forme de DAG Airflow.
- DuckDB embarqué : moteur SQL analytique open source, sans serveur à administrer ; des jobs de quelques milliers à plus de 50 millions de lignes s’exécutent souvent en quelques secondes.
- Pipeline as Code : jobs SQL et DAG Airflow en Python, versionnés dans Git et déployés par Terraform.
- Gouvernance par le data lineage : chaque transformation d’origine reste reliée au SQL réellement exécuté.
- Zéro lock-in : conteneurisé, Java / Python, aucune licence ni roadmap propriétaire.
Point clé : avec {oa-tbx}, les flux migrés deviennent du SQL ouvert, lisible et auditable ligne à ligne, exécutable sur tout environnement.
Découvrir {oa-tbx} → · La migration ETL vers {oa-tbx} en détail →
