Migration DataViz - interopérabilité SQL et couche sémantique - {oa-lake}
Les plateformes décisionnelles reposent souvent sur plusieurs bases de données, plusieurs data warehouses / data lakes et plusieurs outils de restitution. Historiquement, elles s’appuyaient aussi sur une couche sémantique permettant aux utilisateurs de manipuler des objets métier — « clients », « contrats », « produits », « chiffre d’affaires » — plutôt que des tables ou des requêtes SQL.
{oa-lake} répond à ces deux besoins dans un même middleware :
- une couche d’interopérabilité SQL, intermédiaire entre les sources de données et les outils de datavisualisation, qui fédère les requêtes et exécute les traitements (mini pipelines SQL) ;
- une couche sémantique intégrée, qui centralise objets métier, dimensions, mesures, KPI, règles de calcul et sécurité, puis les expose à tous les outils consommateurs.
Point clé : les sources de données et les outils de restitution deviennent indépendants les uns des autres ; les outils manipulent des objets métier, les structures physiques restent masquées.
Architecture
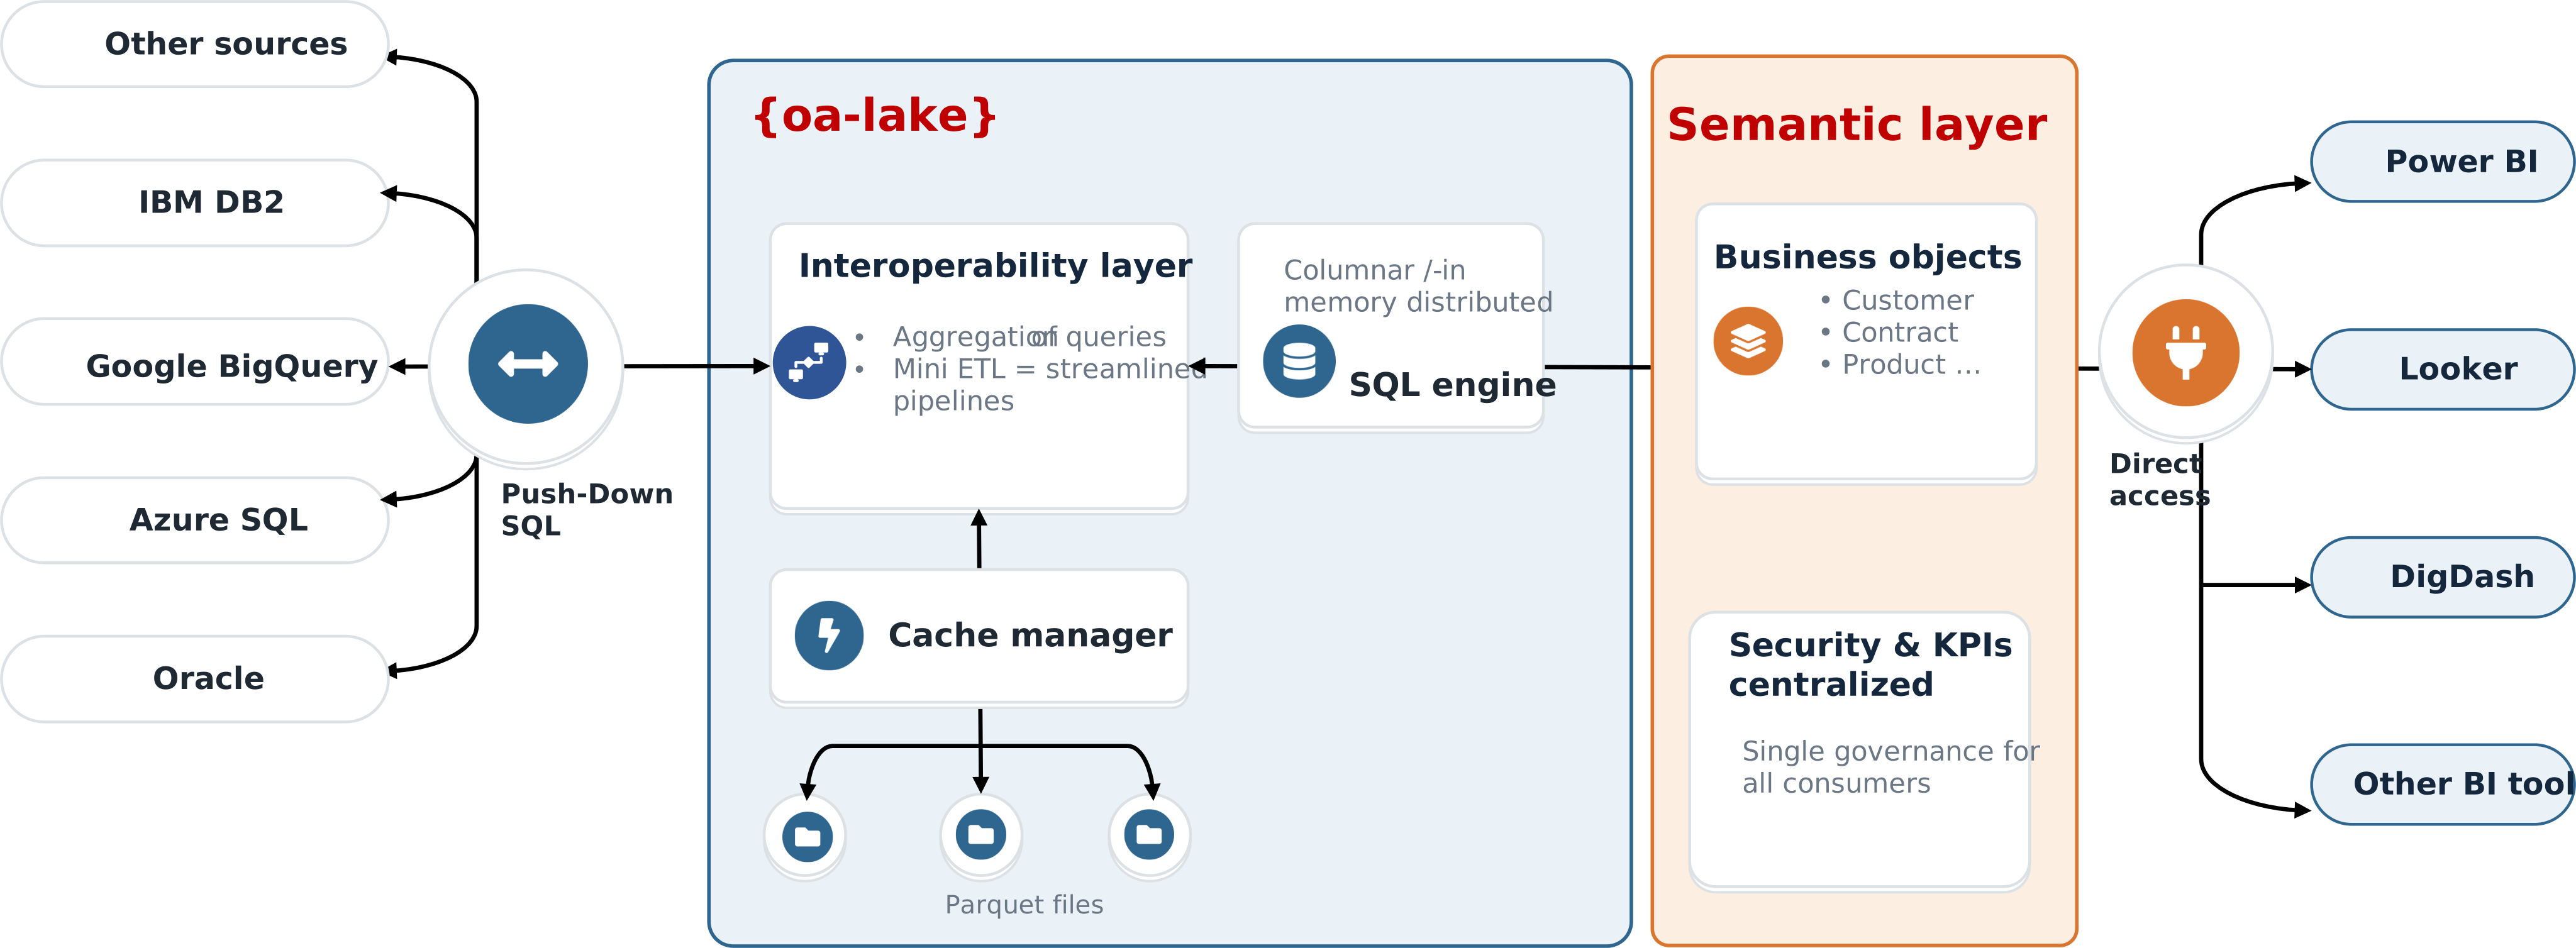
{oa-lake} se connecte simultanément à plusieurs systèmes de données : bases relationnelles, data warehouses, lakehouses, fichiers ou APIs.
Les requêtes sont fédérées par un moteur SQL distribué qui exécute les jointures, calculs et transformations nécessaires.
La couche sémantique centralise les dimensions, mesures, hiérarchies, KPI et règles de calcul, définis une seule fois puis exposés aux outils consommateurs. Contrairement à certaines couches sémantiques du marché, elle ne nécessite ni modèle physique spécifique, ni table pivot, ni chemin de navigation imposé : les relations sont calculées dynamiquement à partir du modèle existant.
Point clé : un modèle métier unique pour toutes les données et tous les outils consommateurs.
Sources de données
Les données restent dans leurs systèmes d’origine.
Oracle, SQL Server, PostgreSQL, DB2, BigQuery, Snowflake, Redshift, Azure SQL (et autres) ou des fichiers peuvent être interrogés dans une même requête, et un même objet métier peut combiner plusieurs sources.
Le mécanisme de Push-Down SQL évite toute copie systématique des données : les requêtes et les filtres utilisateurs sont propagés jusqu’aux systèmes existants, dans le respect des architectures en place.
Usage typique : construire un dashboard ou un KPI à partir de données réparties sur plusieurs plateformes, sans migration préalable.
Objets métier et couche sémantique
Les catalogues exposés par {oa-lake} regroupent les dimensions, mesures, KPI, hiérarchies et nomenclatures métier.
Les relations entre objets sont définies dans la couche sémantique et non dans les outils de restitution ; les catalogues peuvent être organisés indépendamment des structures physiques des bases de données.
Les règles de gestion ne sont plus dupliquées dans chaque plateforme de datavisualisation : la couche sémantique devient le point d’entrée unique pour les outils de restitution.
Point clé : une seule définition des indicateurs pour l’ensemble du système décisionnel.
Génération SQL
Les requêtes SQL sont générées dynamiquement à partir des objets métier, dimensions, mesures et filtres sélectionnés.
Les jointures, agrégations et règles de calcul sont appliquées par le moteur.
Le SQL produit reste standard, portable et exécutable par {oa-lake} ou par tout moteur SQL compatible, ce qui limite le lock-in technologique.
Point clé : les utilisateurs manipulent des objets métier ; le SQL est généré automatiquement.
Interface d’exploration
{oa-lake} est livré avec une interface d’exploration des couches sémantiques.
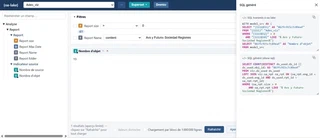
La couche sémantique sélectionnée (en haut à gauche) expose une arborescence d’objets métier ; les objets basculés à droite servent de champs ou de filtres ; le SQL généré est affiché dans le volet latéral ; le résultat peut être envoyé vers Superset, Dremio ou un autre outil de datavisualisation.
- Choix de la couche sémantique : la liste déroulante en haut à gauche donne accès aux catalogues disponibles.
- Sélection des objets métier : l’arborescence (dossiers, dimensions, mesures) est parcourue, puis les objets sont basculés à droite pour être affichés ou utilisés comme filtres.
- Exécution : un aperçu limité est proposé immédiatement ; la requête complète est lancée à la demande.
- Contrôle du SQL : le SQL transmis à {oa-lake} et le SQL physique généré sont consultables et copiables.
- Restitution : le résultat peut être basculé vers un outil de datavisualisation (Superset, Dremio ou autre).
Point clé : les utilisateurs construisent leurs requêtes à partir d’objets métier, sans écrire de SQL, et gardent la visibilité sur le SQL produit.
Moteur SQL et cache
{oa-lake} s’appuie sur un moteur SQL columnar et in-memory. Les requêtes générées par la couche sémantique sont exécutées par ce moteur ou propagées vers les systèmes sources selon le contexte.
Les jeux de données les plus sollicités peuvent être matérialisés au format Parquet. Le Cache Manager pilote ce cache automatiquement selon les usages observés, sans intervention manuelle et indépendamment des outils consommateurs.
Usage typique : accélérer les traitements analytiques les plus coûteux sans modifier les systèmes sources.
Sécurité
La sécurité est gérée au niveau de la couche sémantique.
Les restrictions d’accès, profils utilisateurs, catalogues métier et filtres de sécurité sont appliqués avant génération des requêtes.
Cette approche permet de reproduire les mécanismes de sécurité rencontrés dans des plateformes telles que SAP BusinessObjects ou IBM Cognos.
Point clé : les règles de sécurité sont définies une seule fois puis appliquées à tous les outils connectés.
Restitution
Les catalogues exposés par {oa-lake} peuvent être consommés par tout outil capable d’interroger une source PostgreSQL ou SQL.
Power BI, Looker, Spotfire, Tableau, Qlik, SAP BusinessObjects ou d’autres plateformes accèdent aux mêmes objets métier, dimensions, mesures et KPI.
Changer d’outil de datavisualisation n’implique plus de reconstruire les dimensions, mesures et règles de calcul.
Résultat : plusieurs plateformes peuvent partager le même catalogue métier sans duplication des règles de calcul.
Migration progressive
Plusieurs outils peuvent coexister pendant une phase de transition : un même modèle métier peut être exposé simultanément vers plusieurs plateformes de restitution.
Résultat : migration progressive des usages sans modification des systèmes de données.
Gouvernance et data lineage
Les objets métier, KPI, dimensions, mesures et règles de calcul sont centralisés dans un référentiel unique. Les évolutions fonctionnelles sont réalisées dans la couche sémantique de {oa-lake} puis immédiatement disponibles pour les outils connectés.
Le data lineage reconstruit par {openAudit} reste disponible sur l’ensemble de la chaîne, depuis les systèmes sources jusqu’aux indicateurs exposés dans les dashboards.
Point clé : {oa-lake} constitue le point central de définition des objets métier et des KPI, et les transformations restent traçables sur toute l’architecture.
