Data lineage - les principes de la conteneurisation des connecteurs
juil. 2, 2026 · 3 min. de lecture
ressources

La collecte {openAudit} repose sur des composants conteneurisés déployés dans l’environnement du Client, au plus près des systèmes analysés : un conteneur par technologie (bases de données, plateformes ETL/ELT, outils de data visualisation, bases d’audit), compatible Docker et Podman, en déploiement On-Premise, SaaS ou hybride.

ETL / ELT
SAP Data ServicesIBM DataStageTalendSSISAb InitioStambiadbtOracle Data IntegratorInformatica PowerCenter
Bases de données
OracleTeradataIBM DB2SQL ServerGoogle BigQueryPostgreSQL
Langages et scripts
SQLJavaPerlCOBOL
Datavisualisation et reporting
SAP BusinessObjectsIBM CognosPower BITableauQlik SenseSSRSCrystal ReportsDigDashStrategySASLookerSpotfire

Point clé : extracteurs et anonymiseurs sont découplés des moteurs de traitement ; chaque composant se déploie et se met à jour indépendamment.
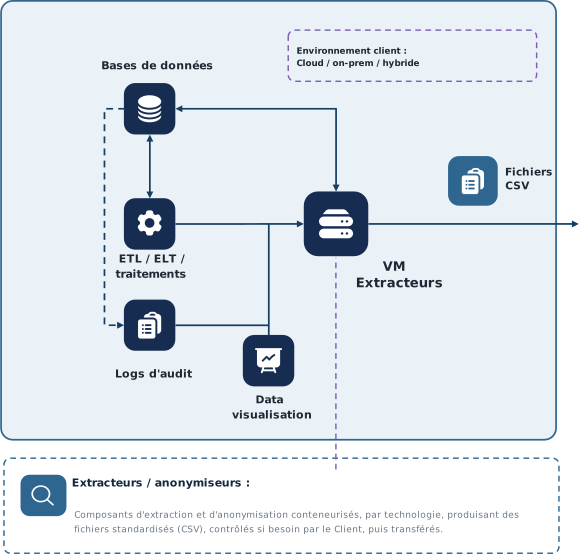
Schéma : les principes de la conteneurisation des connecteurs

Extraction

Les extracteurs se connectent aux technologies analysées via des comptes de service dédiés et collectent les métadonnées des bases de données, plateformes ETL/ELT, outils de datavisualisation, bases d’audit et du scheduleur. Chaque extracteur produit un format de sortie homogène, quelle que soit la technologie.

Anonymisation

Lorsqu’elle est requise, un conteneur d’anonymisation s’insère entre la collecte et la production des fichiers d’échange : chaînes de caractères, paramètres applicatifs et valeurs littérales (constantes SQL…) sont remplacés par des variables techniques. Les dépendances sont conservées, les informations sensibles supprimées.

Fichiers d’échange

Les composants produisent des fichiers CSV standardisés : objets techniques, dépendances, transformations et, lorsqu’elles sont disponibles, informations d’usage. Le Client peut les archiver, les contrôler ou les valider avant leur transfert.

Traitement

Les composants centraux d’{openAudit} exploitent ces fichiers pour reconstruire les dépendances, consolider les métadonnées, intégrer les usages issus des logs d’audit et produire le data lineage.

Résultat : une chaîne de collecte homogène, indépendante des technologies analysées et des modes de déploiement.
Questions fréquentes

Comment {openAudit} collecte-t-il les métadonnées ?
Avec des composants conteneurisés déployés dans l’environnement du client, un par technologie. Ils se connectent aux bases de données, plateformes ETL/ELT, outils de datavisualisation, bases d’audit et au scheduleur avec des comptes de service dédiés, et produisent des fichiers CSV standardisés.
Quelles technologies sont couvertes par les collecteurs ?
Côté ETL/ELT : SAP Data Services, IBM DataStage, Talend, SSIS, Ab Initio, Stambia, dbt, Oracle Data Integrator et Informatica PowerCenter. Côté bases : Oracle, Teradata, IBM DB2, SQL Server, Google BigQuery et PostgreSQL. Côté dataviz : SAP BusinessObjects, IBM Cognos, Power BI, Tableau, Qlik Sense, SSRS, Crystal Reports, DigDash, Strategy, SAS, Looker et Spotfire. Ainsi que les langages SQL, Java, Perl et COBOL.
Comment fonctionne l'anonymisation des métadonnées ?
Un conteneur dédié, placé entre la collecte et le transfert, remplace les chaînes de caractères, paramètres applicatifs et valeurs littérales par des variables techniques, avant la production des fichiers d’échange. Les dépendances techniques sont conservées.
Dans quels environnements les collecteurs peuvent-ils être déployés ?
En On-Premise, en SaaS ou en hybride, avec Docker ou Podman. Chaque composant peut être déployé et mis à jour indépendamment.