Data lineage - architecture on prem'
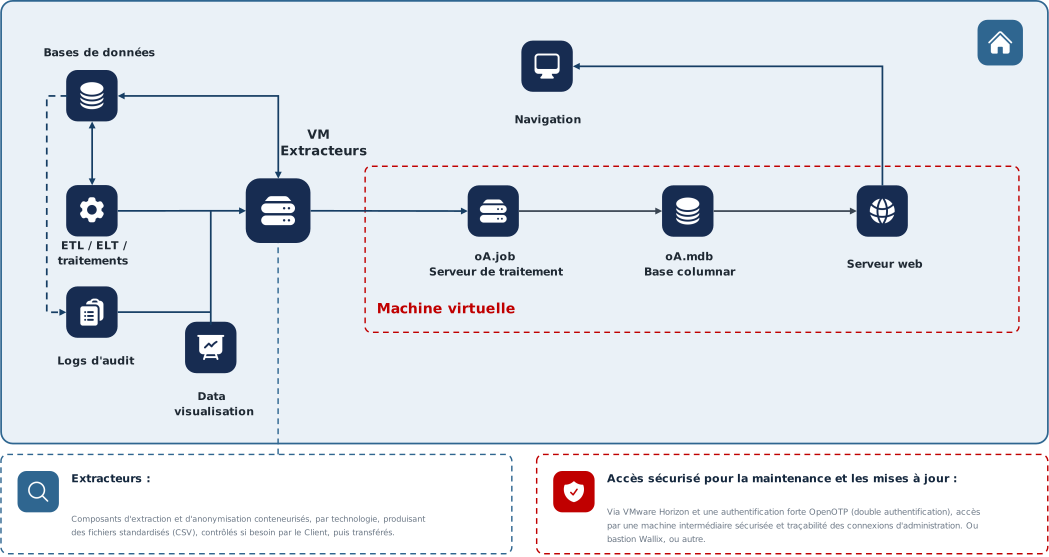
Dans les environnements les plus exigeants en matière de sécurité (banque, assurance…), {openAudit} peut être déployé directement chez le Client, On-Premise ou dans un tenant Cloud de son choix, sur une VM dédiée qui héberge la collecte, le traitement et l’exposition du data lineage.
Point clé : traitements, métadonnées et référentiels restent dans l’environnement du Client ; aucun composant SaaS externe n’est requis.
Collecte des métadonnées
Des conteneurs spécialisés par technologie se connectent aux bases de données, plateformes ETL/ELT, outils de data visualisation et bases d’audit via des comptes de service dédiés ; les mots de passe sont chiffrés après leur première utilisation. Ils produisent des fichiers CSV standardisés, contrôlables par le Client avant traitement.
Les logs d’audit, qui peuvent contenir des informations sensibles, peuvent être anonymisés par un conteneur dédié avant leur intégration.
Traitement
Le serveur oA.Job assure le parsing et la consolidation des métadonnées, stockées dans la base columnar oA.mdb (MonetDB). Ce référentiel, très riche, peut être exporté (dump) au format souhaité par le Client pour des analyses spécifiques ; des requêtes sont fournies pour l’explorer.
Exposition
Le data lineage est consultable via le portail Web Mosaïc, hébergé sur la VM. Il peut aussi alimenter une solution tierce, typiquement un data catalogue.
Cartographie globale des flux
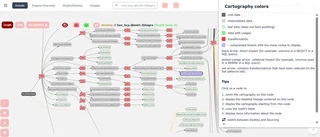
Reconstruction automatique des dépendances entre bases de données, traitements ETL/ELT et usages dans les outils de data visualisation.
Usage typique : analyse d’impact avant modification d’une table ou d’un indicateur métier.
Analyse des usages
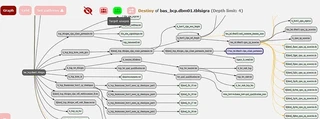
Le croisement du data lineage avec les logs d’audit distingue les objets réellement utilisés des branches non consommées, et fait apparaître les opportunités de simplification.
Data Lineage de détail
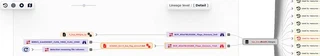
Navigation jusqu’au niveau champ, avec accès direct au code des transformations (drill through) pour identifier et corriger un problème dans un flux.
Data Lineage dans les dashboards
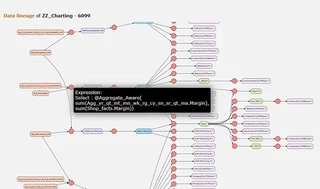
Traçabilité de bout en bout, des alimentations jusqu’à la cellule du dashboard, en passant par les règles de gestion.
Usage typique : validation d’un indicateur métier ou analyse de l’origine d’une valeur affichée.